
Auf unserem OpenLM Summit 2026 hat die Steadforce GmbH unsere Teilnehmer in die Welt von Kubernetes und Containern eingeführt. Das 1985 gegründete Tech- Unternehmen hat den Wandel der Software-Bereitstellung vom physischen Server über virtuelle Maschinen hin zu Containern erlebt und seine Kunden dabei begleitet.
Da die neue OpenLM Platform auf Kubernetes läuft, ist es uns wichtig, unseren Kunden einen transparenten Einblick in diese zugrundeliegende Technologie zu bieten. Wir freuen uns, dieses Wissen nun auch weiteren Kunden und Interessenten zur Verfügung zu stellen.
Kubernetes Self-Healing: Automatische Fehlerbehebung für eine hochverfügbare B2B-Cloud-Infrastruktur.
Hier eine Inhaltsübersicht:
Was ist Kubernetes?
Kubernetes ist eine Open-Source-Plattform zur automatischen Bereitstellung, Skalierung und Verwaltung von Container-Anwendungen.
Diese Definition wirft jedoch ein paar Fragen auf, vor allem für diejenigen, die sich nicht ständig mit Software-Architektur beschäftigen.
Zunächst einmal die grundlegende Frage – warum überhaupt Kubernetes? Um dies zu beantworten, müssen wir uns etwas intensiver mit der Entwicklung und Bereitstellung von Software beschäftigen.
Software-Bereitstellung im Wandel der Zeit
In den 1990er Jahren war der klassische Ansatz, einen physischen Server pro Anwendung bereitzustellen. Teils war das sicherheitsbedingt, teils kam das als Anforderung der Software-Hersteller. Es dauerte Wochen bis Monate für die Bereitstellung neuer Hardware. Installationen und Updates mussten manuell erfolgen. Die Serverauslastung war niedrig, die Kosten hoch. Zudem konnte ein Serverausfall alles lahmlegen.
Um das Problem der starren, ressourcenfressenden Server-Infrastrukturen zu lösen, setzte sich in den 2000ern die Server-Virtualisierung durch. Virtuelle Maschinen ermöglichten, dass mehrere Anwendungen auf demselben physischen Server liefen. Dadurch wurde die Auslastung verbessert, hatte allerdings den Nachteil, dass jede Virtuelle Maschine ihr eigenes komplettes Betriebssystem mitbringen musste.
2013 kamen dann Container als logischer nächste Schritt in der Evolution der Softwarebereitstellung. Dies brachte eine noch effizientere Serverauslastung, eine noch schnellere Bereitstellung der Software und insgesamt mehr Flexibilität. Wie genau das funktioniert, darauf gehen wir im Folgenden ein.
Was sind Container?
Zunächst einmal müssen wir klären, was genau Container eigentlich sind. Container sind eigenständige Pakete, die sich den Kern eines gemeinsamen Betriebssystems teilen. Ein Container bringt alles mit, was eine Anwendung zum Laufen benötigt: den Anwendungscode, die Bibliotheken, die Standard-Konfiguration sowie eine minimale Laufzeitumgebung.
Container ersetzen Virtuelle Maschinen nicht, oft laufen sie sogar in ihnen. Sie sind jedoch wesentlich effizienter, da sie auf ein eigenes Betriebssystem verzichten. Dadurch sind sie oft nur wenige Megabyte groß und starten in Sekunden. Zudem sind sie als standardisierte, isolierte Pakete extrem leicht transportierbar.
Docker: Der Standard für Container
Docker kam 2013 an den Markt und wurde zum Industrie-Standard für Container. Es besteht aus der Dockerfile, die in Form eines Image wie ein Bauplan beschreibt, was die Anwendung braucht. Das fertig gestellte Image ist ein starres, unveränderliches Paket, das den Code, die Laufzeitumgebung und alle Abhängigkeiten enthält. Um dieses Image zu teilen, lädt der Entwickler es in ein zentrales Verzeichnis wie z.B. Docker Hub hoch.
Beim Starten eines Containers wird das Original-Image nicht kopiert, sondern dient lediglich als schreibgeschütztes Fundament für eine temporäre Schreibschicht, in der alle Laufzeitänderungen völlig isoliert und ohne Einfluss auf das Basis-Image gespeichert werden. Dadurch entstehen aus einem Image beliebig viele identisch laufende Container.
Wie entstand Kubernetes?
Die Effizienz von Containern befeuerte den Architekturwechsel hin zu Microservices, wodurch IT-Infrastrukturen plötzlich aus tausenden dynamischen Workloads bestanden. Da Docker primär für einzelne Server konzipiert ist, führte die Verteilung dieses riesigen Container-Schwarms über ganze Rechenzentren zu einem manuell unlösbaren Management-Chaos. Kritische Anforderungen wie Ausfallsicherheit, dynamische Diensterkennung und Lastenverteilung ließen sich nicht mehr händisch steuern. Um diesem Problem Herr zu werden, entstand Kubernetes.
Wie ist Kubernetes aufgebaut?
Nachdem wir nun erfahren haben, warum Kubernetes entstand und zum Industrie-Standard für Container wurde, beschäftigen wir uns etwas näher mit der Software-Architektur von Kubernetes.
Die Kubernetes Architektur
Das Kubernetes-Cluster besteht aus einem Control Plane und beliebig vielen Worker Nodes. Das Control Plane ist quasi das Gehirn: Es entscheidet, was wo läuft. Die Worker Nodes entsprechen den Muskeln: Hier laufen die eigentlichen Anwendungen ab.
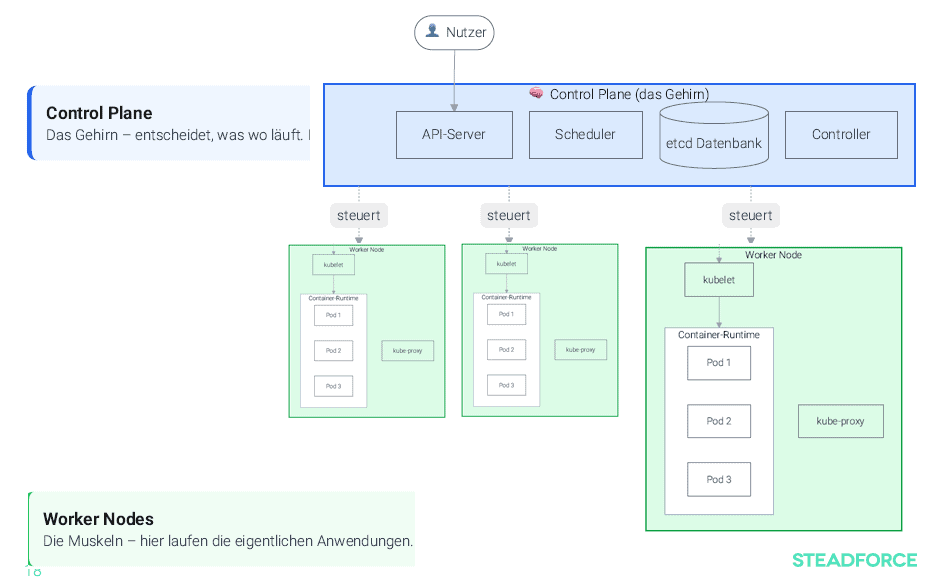
Die vier Bausteine des Control Planes lassen sich durch ihre Rollen erklären:
- Der API-Server als Rezeption: Er dient als zentrale Anlaufstelle. Hier nimmt das System jeden Befehl von Mensch oder Maschine direkt entgegen.
- Die Datenbank etcd als Gedächtnis: Sie merkt sich den gesamten Zustand des Clusters. Dadurch weiß das System exakt, was aktuell wo läuft und konfiguriert ist.
- Der Scheduler als Disponent: Er kümmert sich um alle neuen Aufgaben. Dafür prüft er freie Kapazitäten, Auslastung sowie Regeln und platziert neue Pods auf dem passenden Worker Node.
- Der Controller Manager als Wächter: Er überwacht das gesamte Zusammenspiel. Dafür vergleicht er permanent den Ist-Zustand mit dem gewünschten Soll-Zustand. Bei Abweichungen greift er sofort korrigierend ein.
Die Worker Nodes lassen sich mit einem Projekt-Team vergleichen:
- Das Kubelet als Projektleiter: Er nimmt alle Aufträge der Zentrale an. Er ist der direkte Ansprechpartner vor Ort und wacht darüber, dass sein Team exakt nach Vorgabe arbeitet.
- Die Container-Runtime als Spezialist: Er führt die eigentlichen Aufgaben aus. Auf Anweisung des Projektleiters packt er an, lädt die benötigten Daten und startet die Container.
- Der Kube-Proxy als Vermittler: Er regelt die gesamte Kommunikation. Er steuert den Datenverkehr und leitet alle eingehenden Anfragen zielsicher an den richtigen Spezialisten weiter.
Die Kubernetes Kern-Konzepte
Der Kern von Kubernetes beruht auf verschiedenen Einheiten.
Pod: die kleinste Einheit
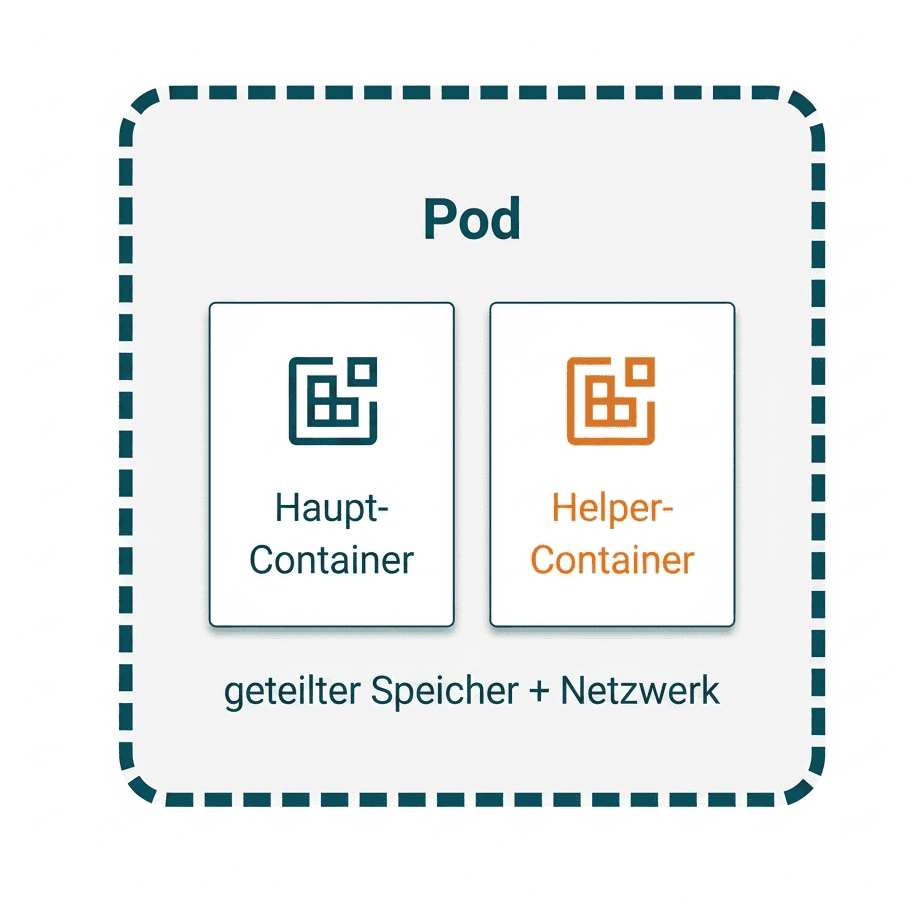
Ein Pod ist die kleinste Einheit in Kubernetes.
- Enthält einen oder mehrere Container, die eng zusammenarbeiten
- Container im selben Pod teilen sich Netzwerk und Speicher
- Hat eine eigene IP-Adresse im Cluster
- Vergänglich: crasht ein Container, wird er neu gestartet – stirbt
der Pod selbst, wird er nicht reanimiert – ein neuer entsteht, so wie
im Soll-Zustand definiert
Deployment: Pods am Leben halten
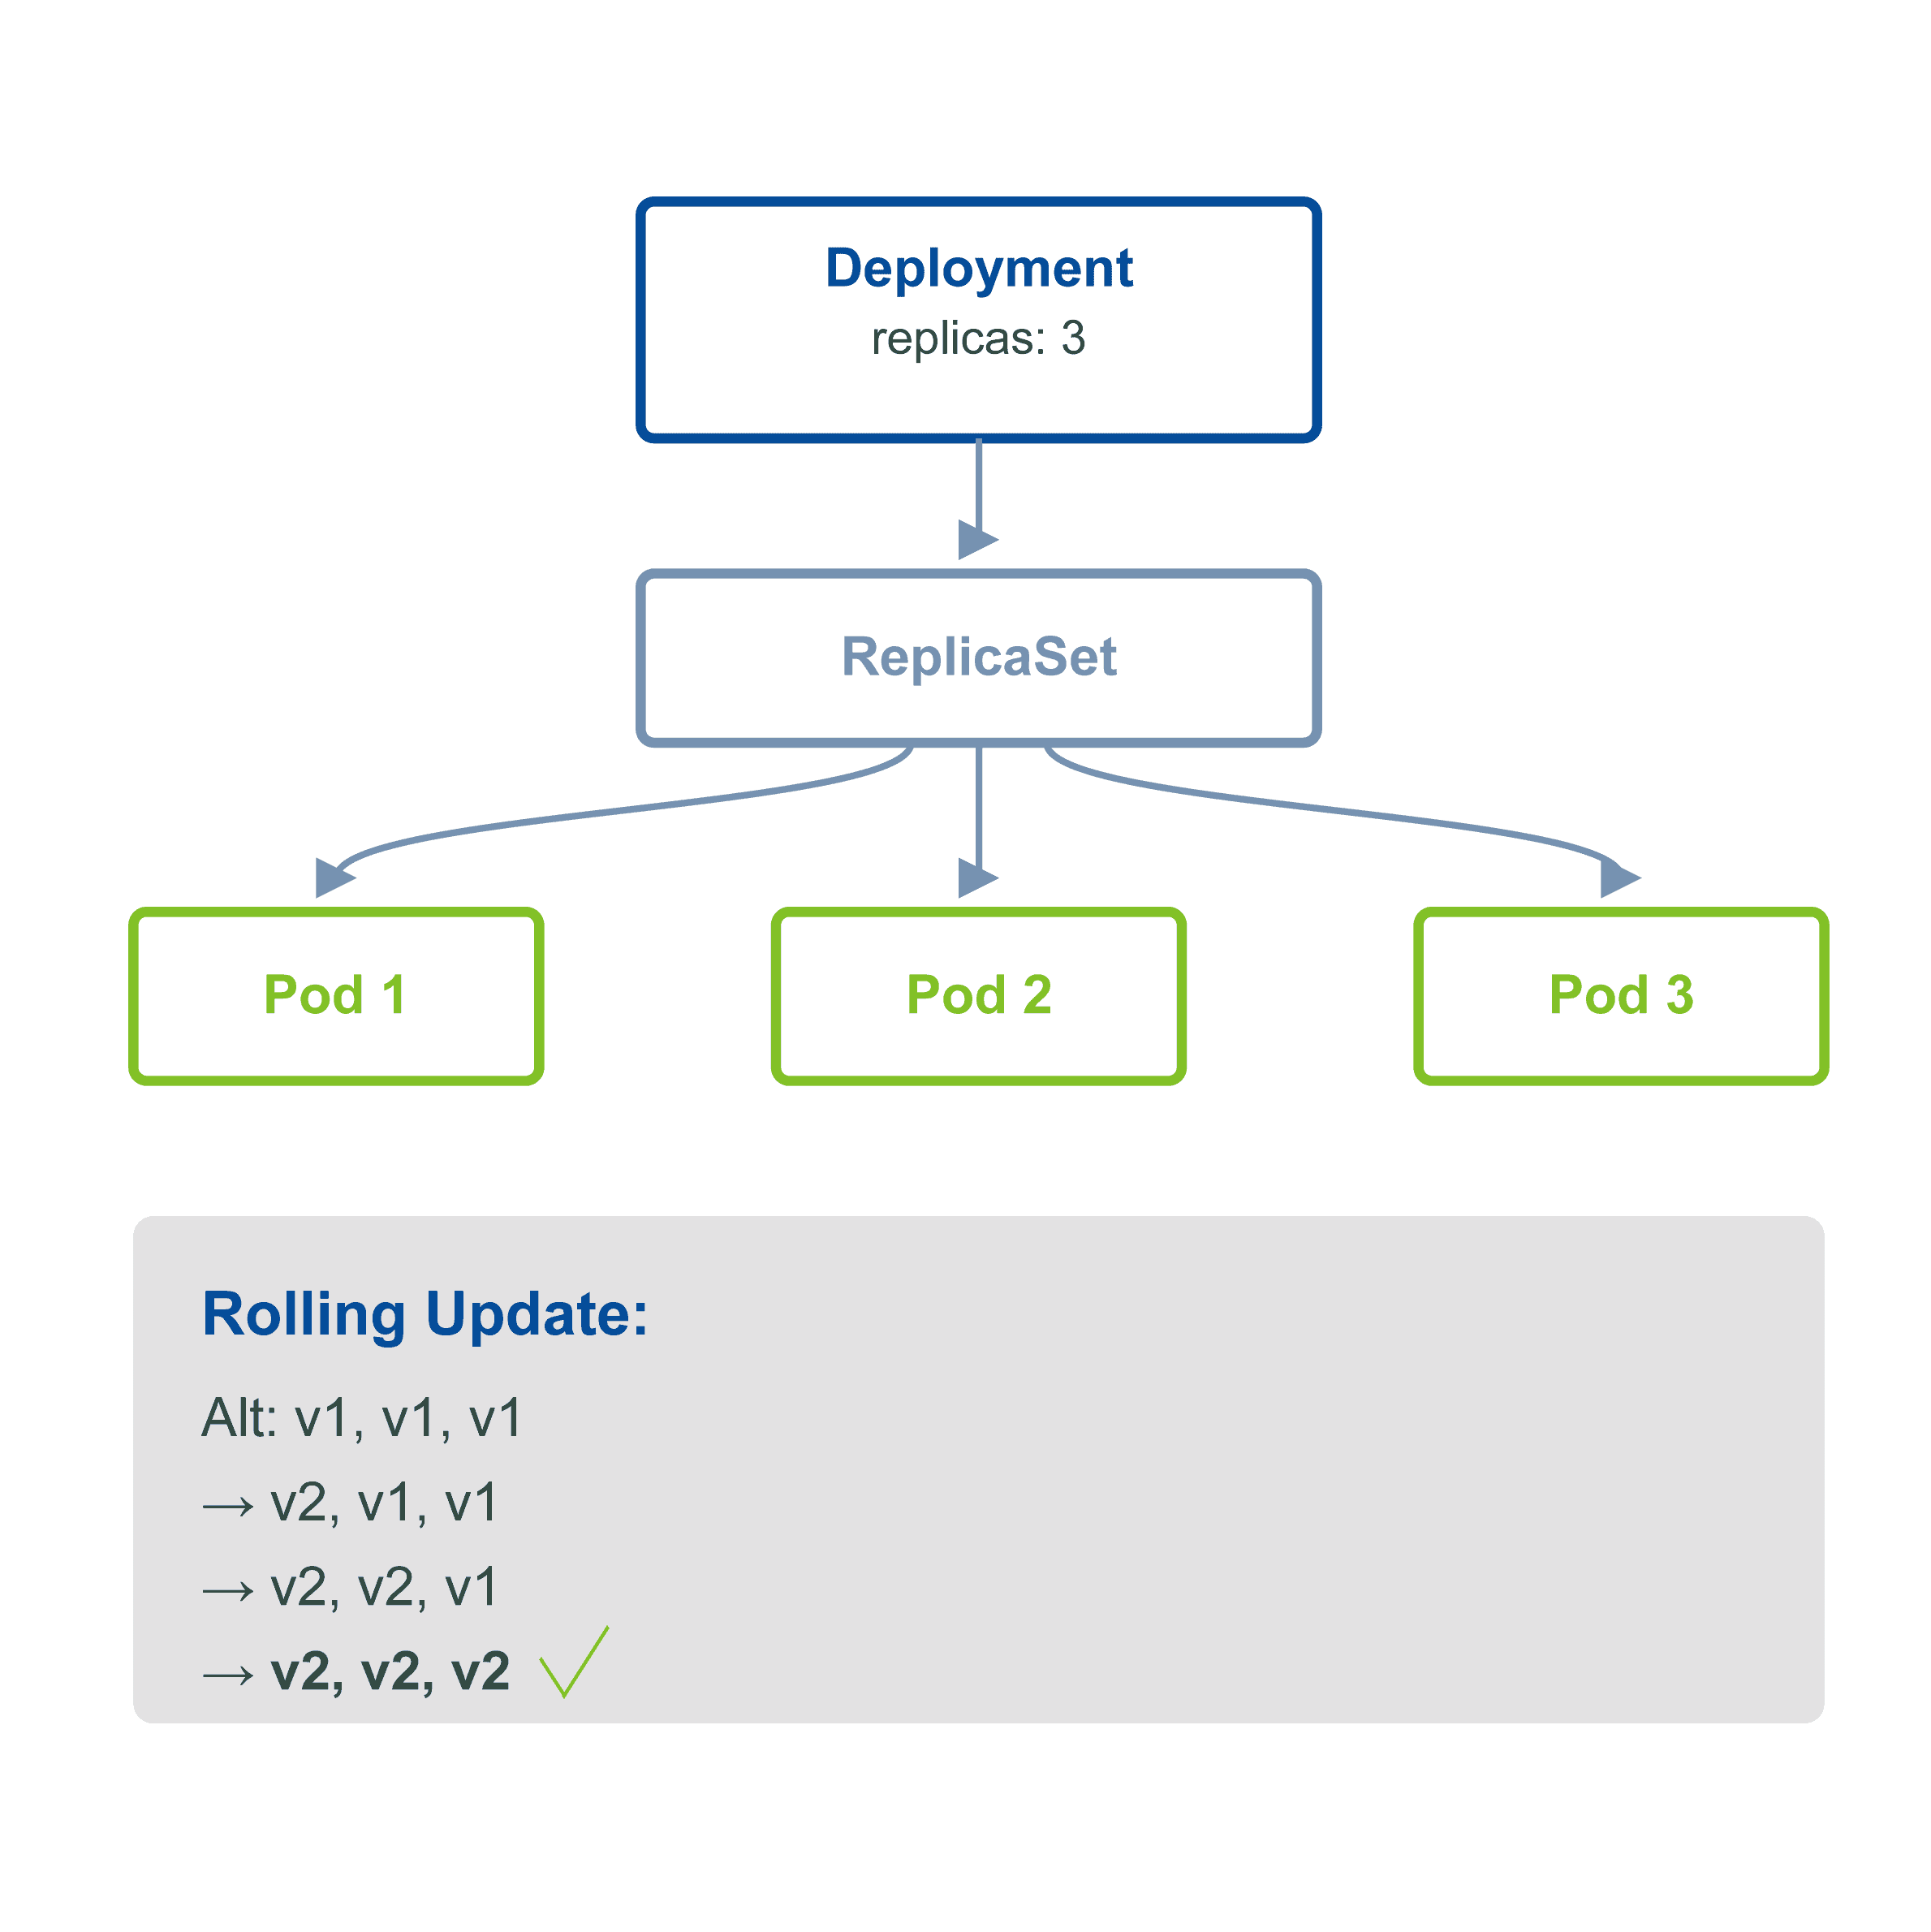
Ein Deployment ist ein „Bauplan“ für Pods.
- Sie sagen: „Ich will 3 Kopien dieser Anwendung.“
- Kubernetes startet 3 Pods – egal auf welchen Nodes.
- Stirbt einer – sofort wird ein neuer gestartet.
- Beim Update: schrittweise austauschen, ohne Downtime
Garantie: Es laufen immer so viele Pods, wie Sie es definiert haben– auch wenn Server ausfallen.
Service: Ein stabiler Eingang
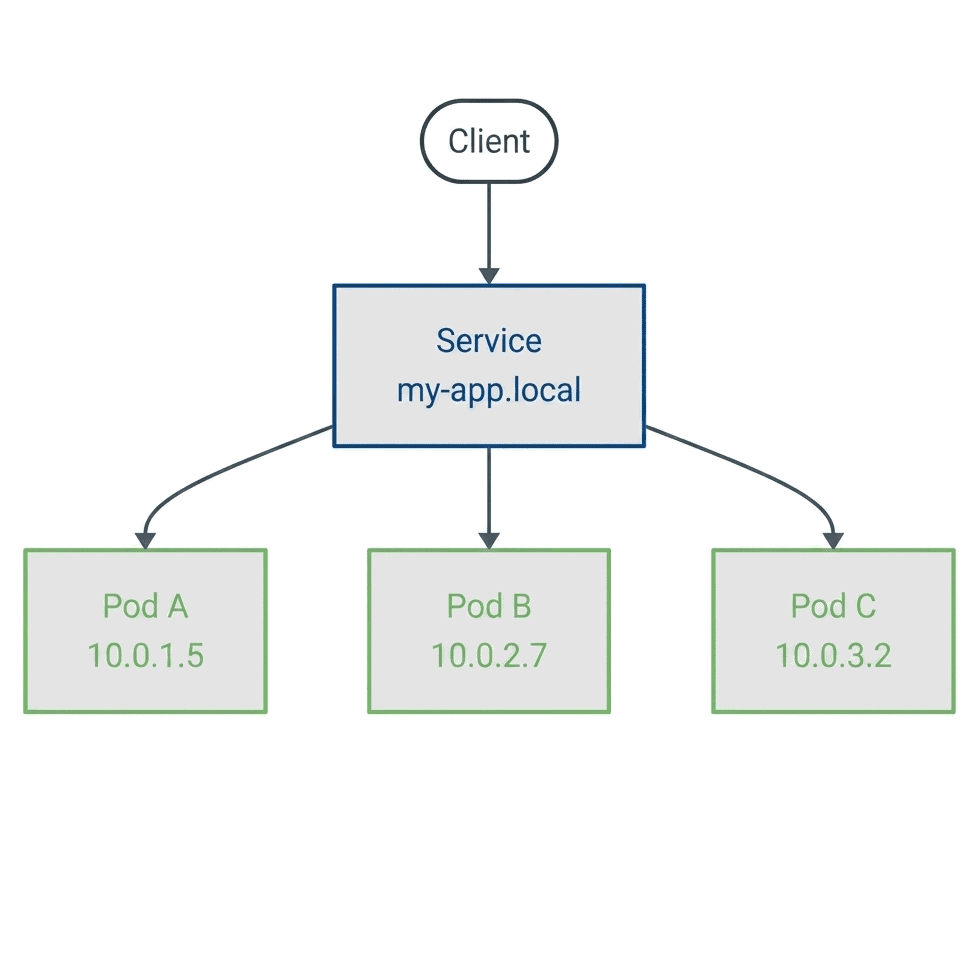
Problem: Pods sind vergänglich – ihre IP-Adressen ändern sich.
Ein Service ist die Lösung: eine stabile Adresse für eine Gruppe von Pods.
- Eine feste IP und ein DNS-Name
- Verteilt Anfragen automatisch (Load Balancing)
- Routet nur zu gesunden Pods
Analogie: Wie eine Hotline – Sie wählen immer dieselbe Nummer, im Hintergrund nimmt der gerade freie Mitarbeiter ab.
Ingress: Tür nach außen
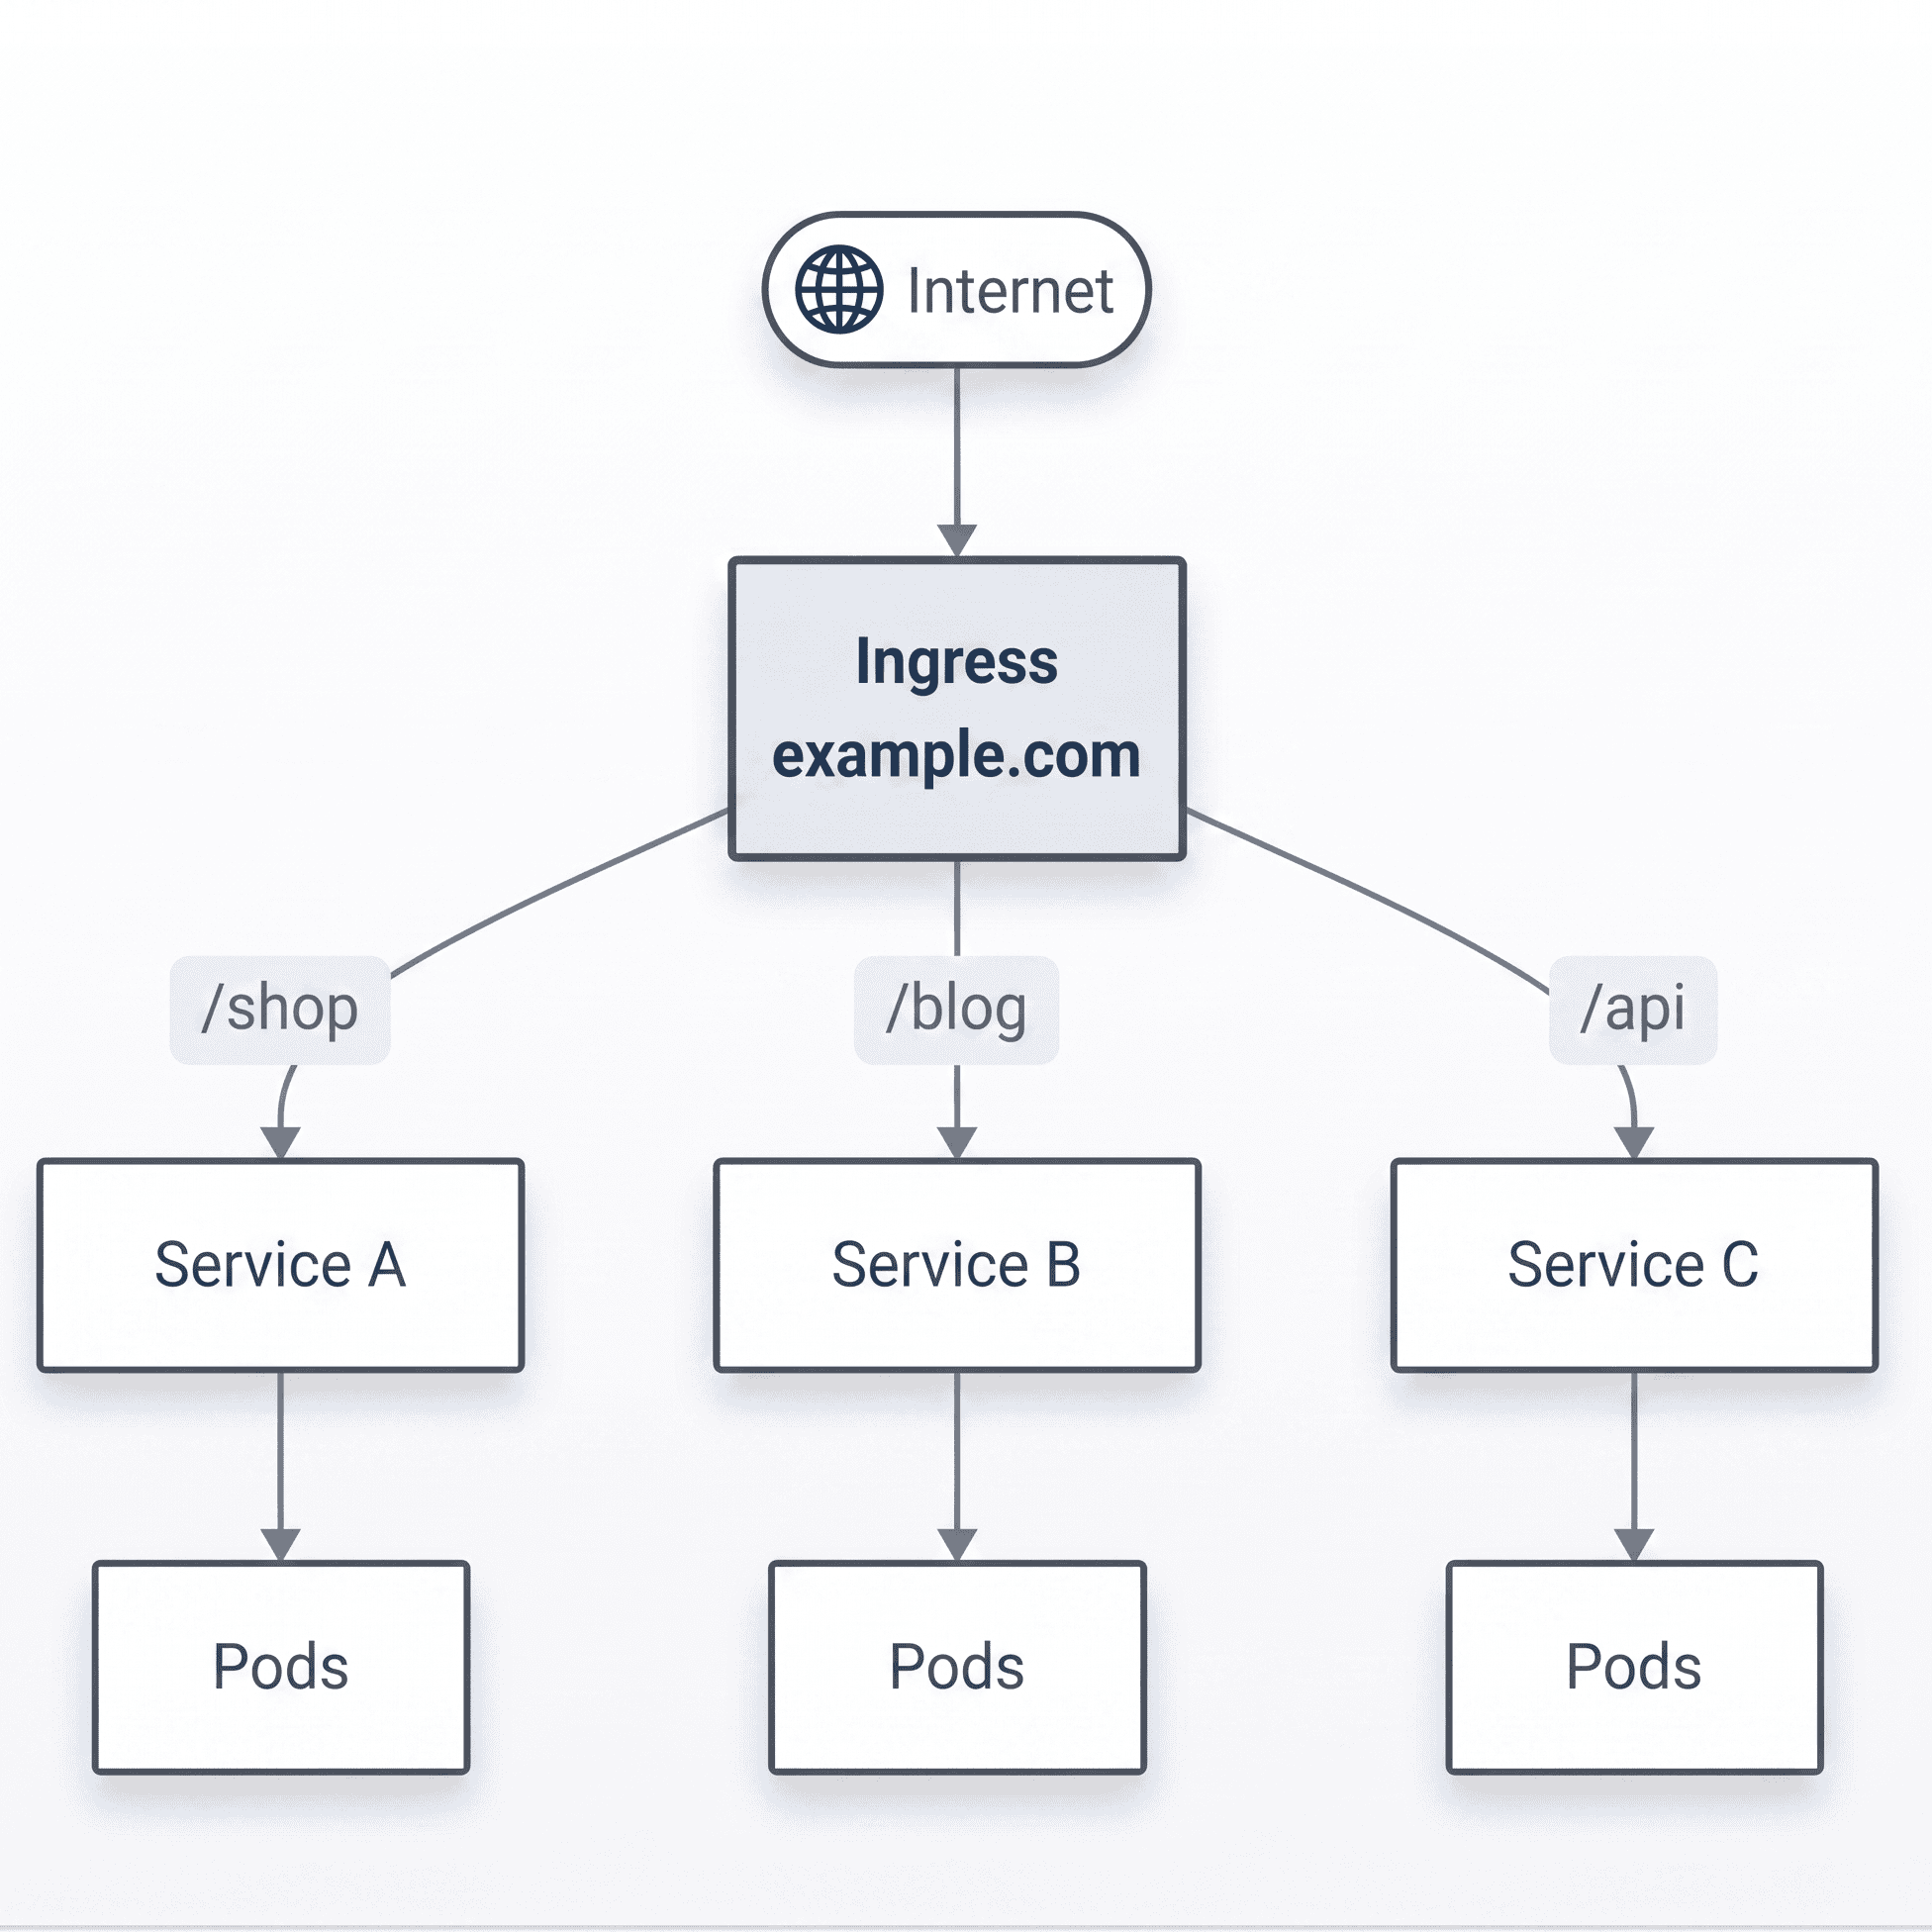
Services arbeiten im Cluster. Aber wie kommen Nutzer von außen rein?
Ingress: Eine Art „Empfangstheke“ für eingehenden HTTP/HTTPS-Verkehr.
- Routing nach Domain: app.firma.de → Service A
- Routing nach Pfad: /api → Service C
- Ver- und Entschlüsselung von HTTPS-Zertifikaten
- Eine öffentliche IP für viele Anwendungen
ConfigMaps: Für nicht-sensitive Konfiguration
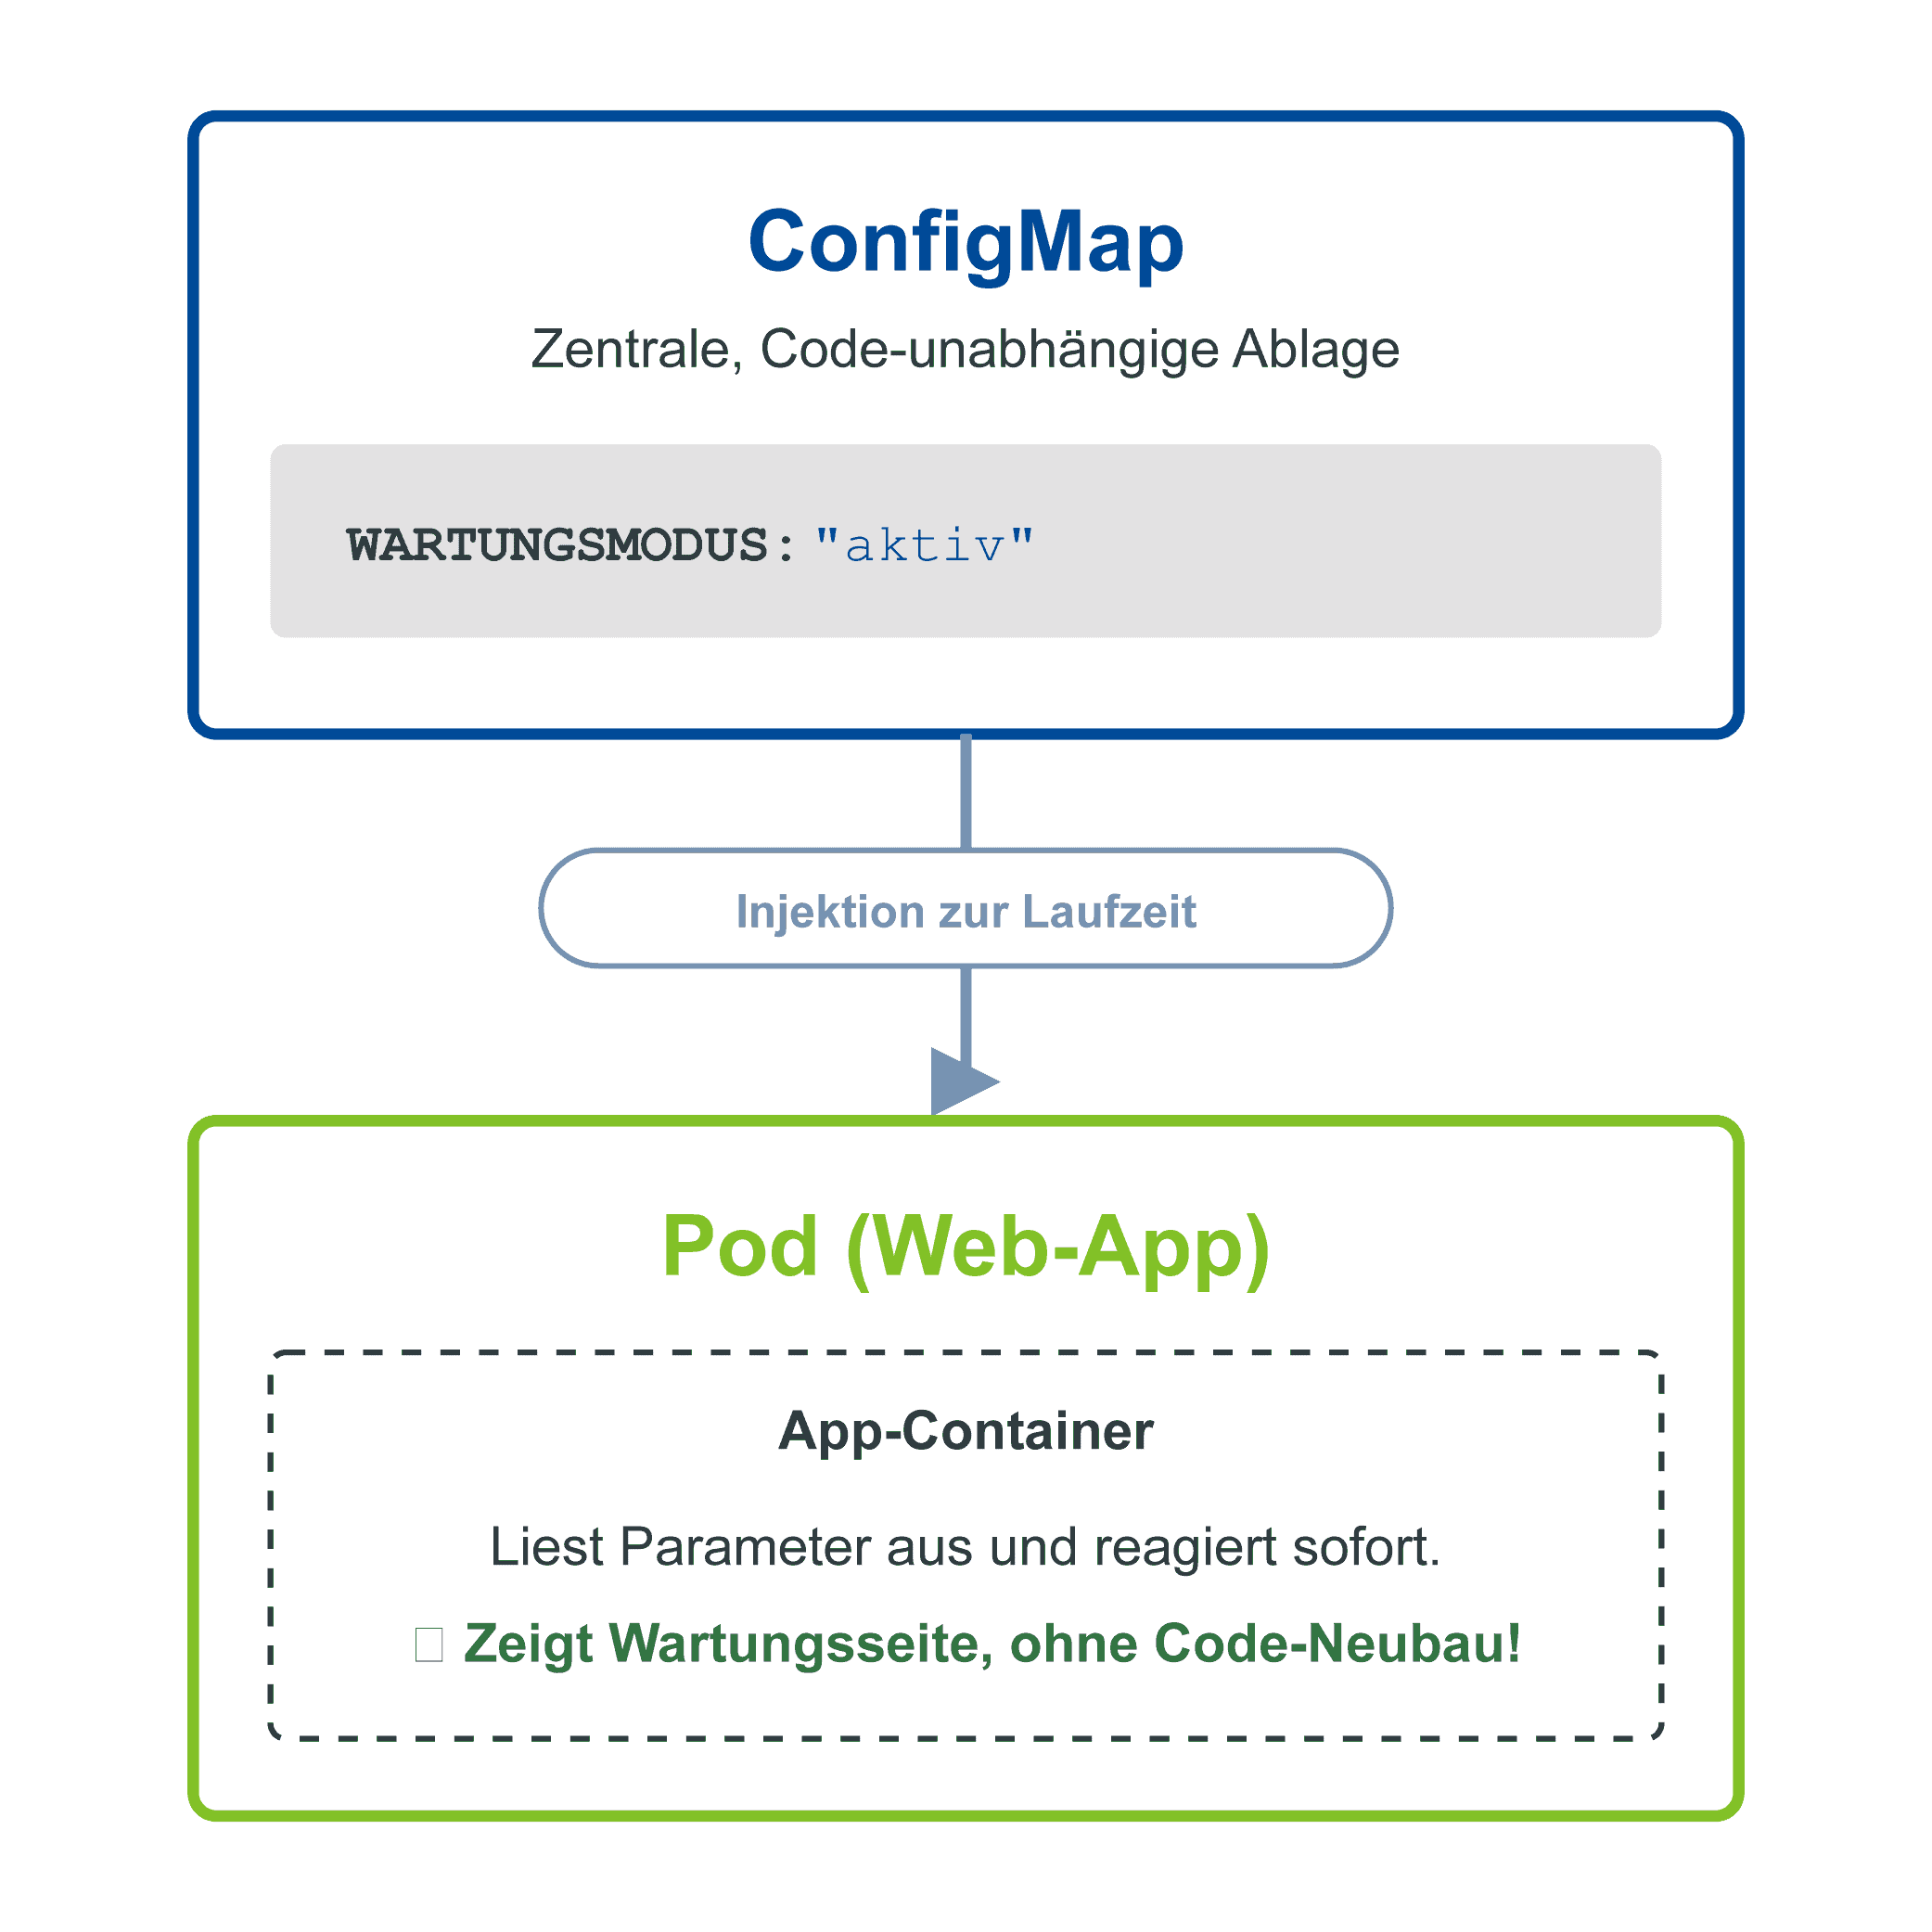
ConfigMaps werden als Dateien oder Umgebungsvariablen in Pods eingebunden.
Es handelt sich nicht nur um statische Basisdaten, sondern auch um temporäre Einstellungen z.B. zur Diagnose oder zur Aktivierung eines Wartungsmodus.
- Datenbank-Hostname
- Feature-Flags
- Log-Level
- URLs anderer Dienste
Secrets: Für sensitive Daten
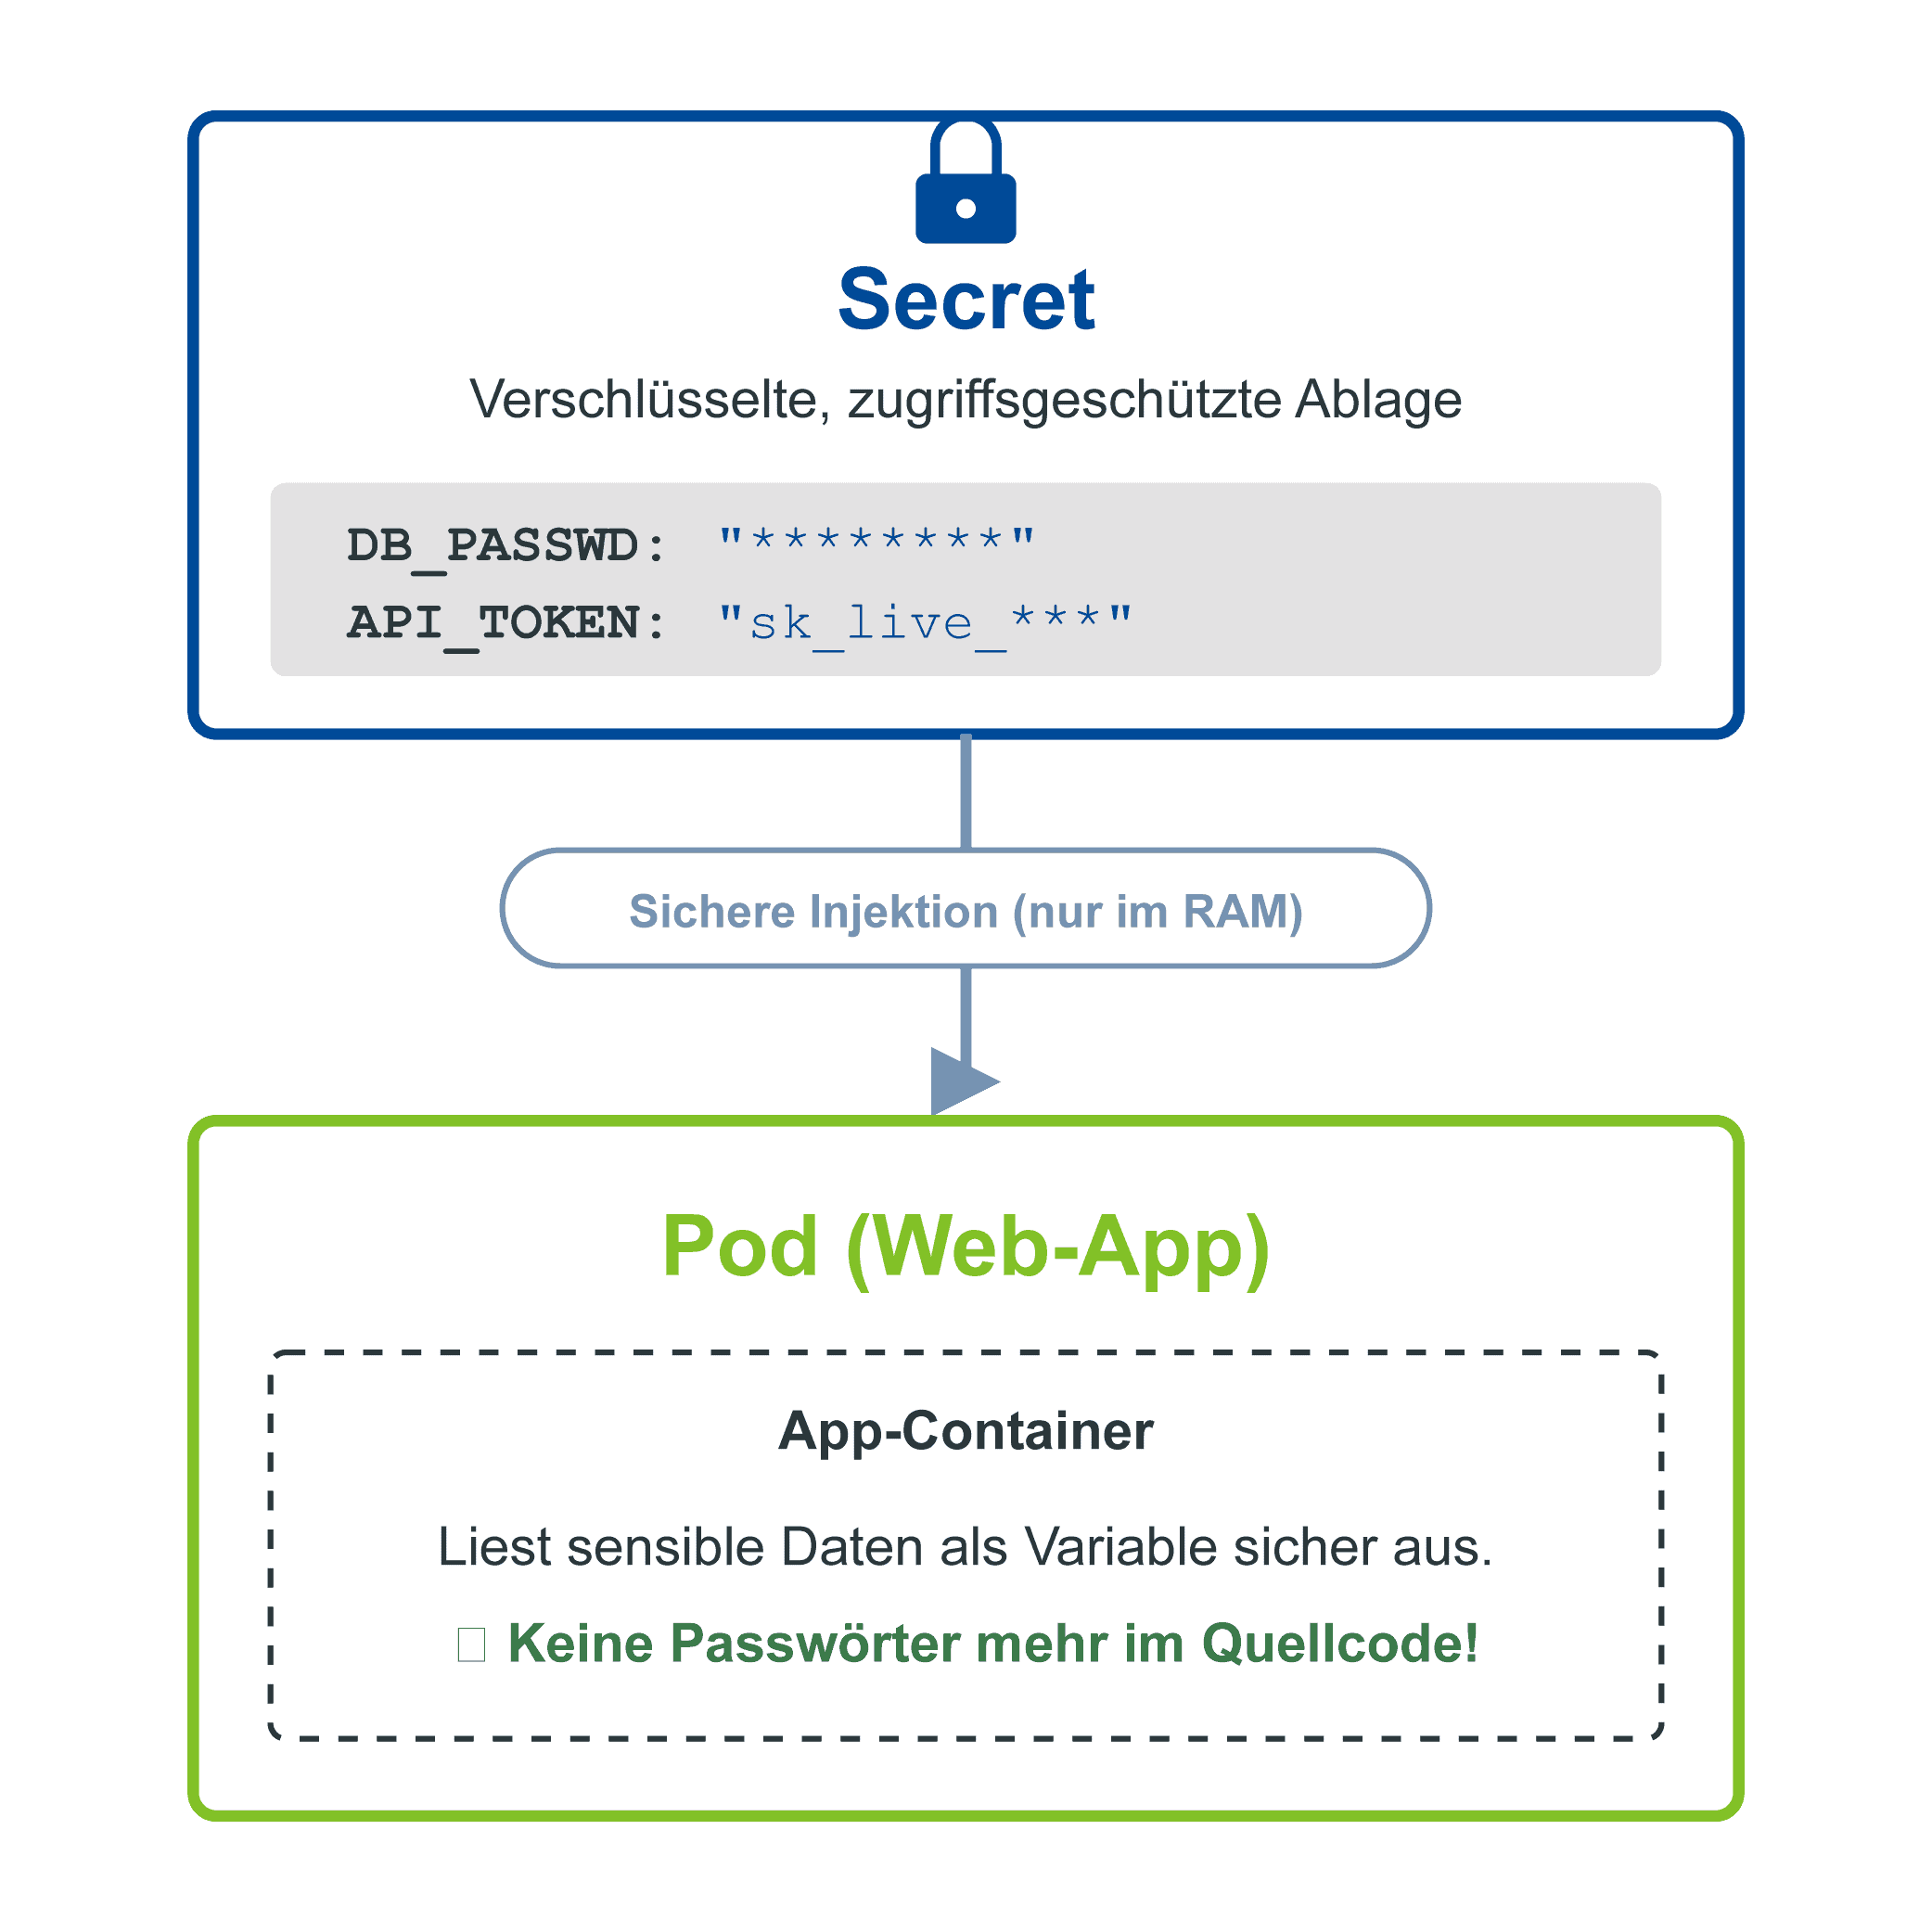
Secrets werden verschlüsselt abgelegt, streng über Zugriffsrechte (RBAC) geschützt und nur im Arbeitsspeicher vorgehalten.
- Passwörter
- API-Schlüssel
- TLS-Zertifikate
- Datenbank-Credentials
Wie bei ConfigMaps entfällt auch hier (z.B. bei Passwortänderungen) der aufwendige Container-Neubau – jedoch mit mehr Sicherheit für sensible Daten.
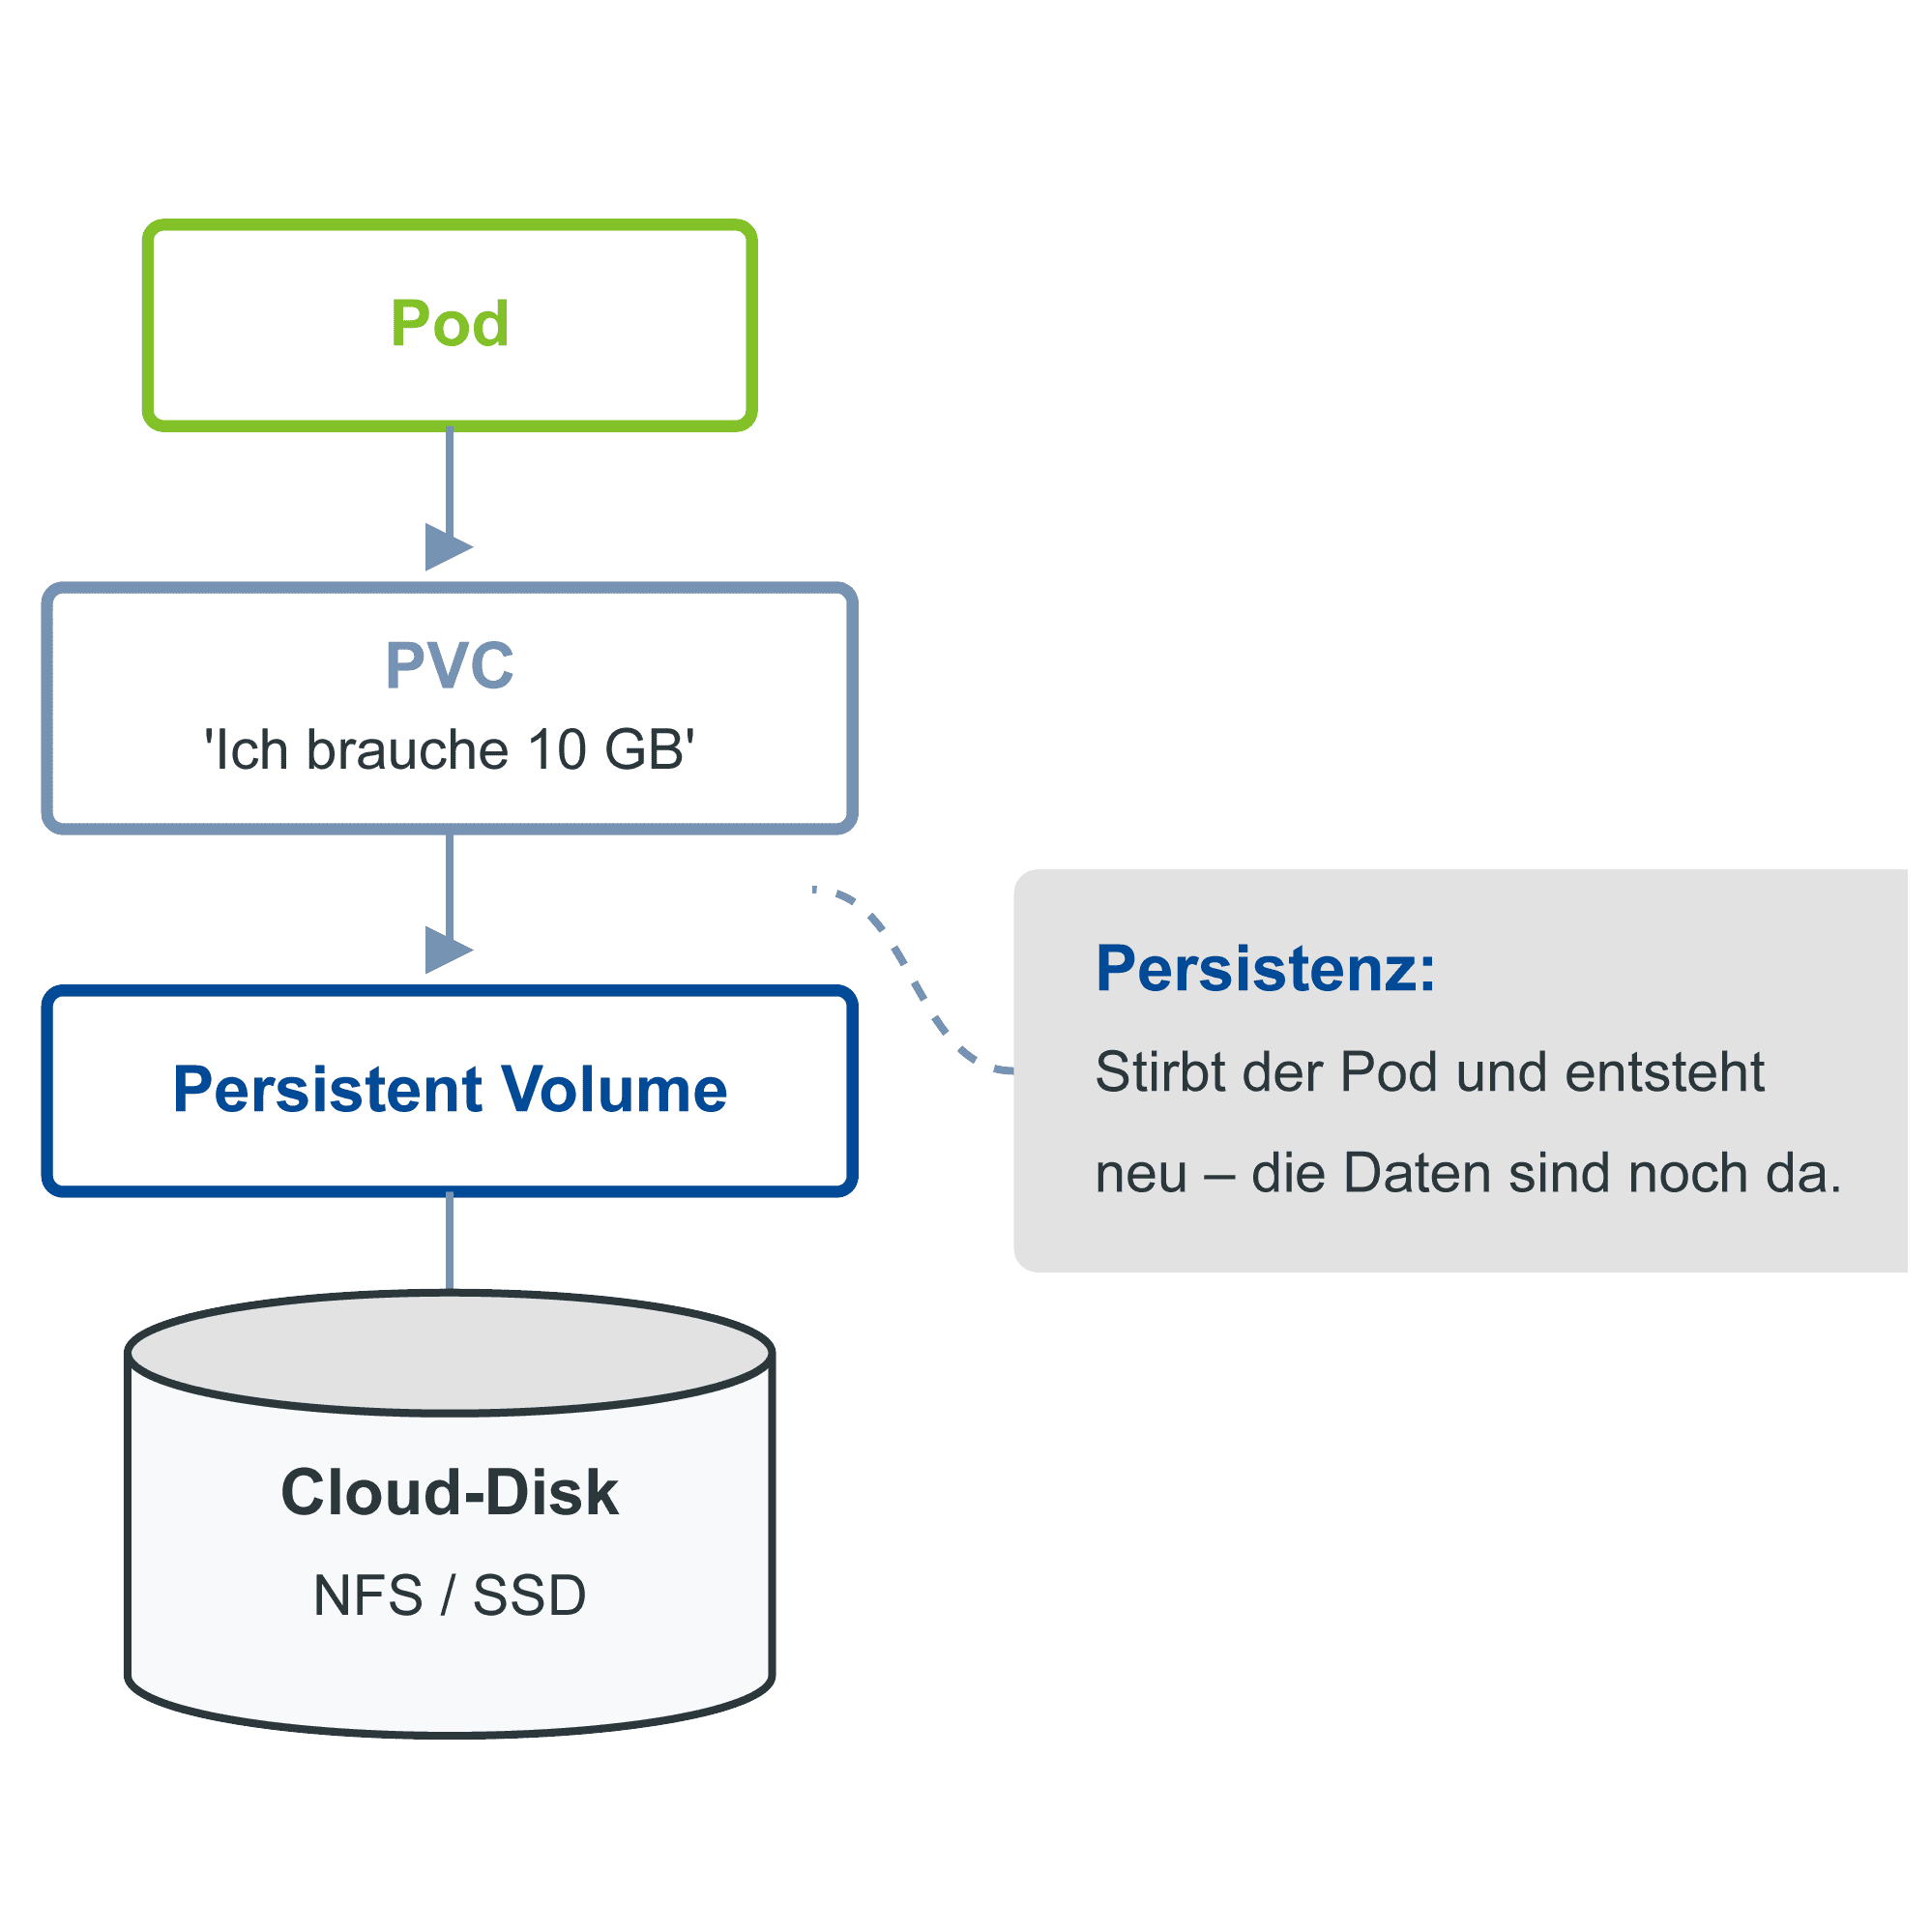
Volumes: Persistente Daten
Pods sind vergänglich – ihre Daten gehen verloren, wenn sie sterben.
Mit Volumes bleiben Daten erhalten.
- PersistentVolume (PV): Ein Stück Speicher im Cluster (Cloud-Disk, NFS, etc.).
- PersistentVolumeClaim (PVC): Eine „Anforderung“ eines Pods: „Ich brauche 10 GB.“
- StorageClass: „Vorlagen“ – z.B. „schnell und teuer“ oder „langsam und billig“.
Namespaces: Räume im Cluster
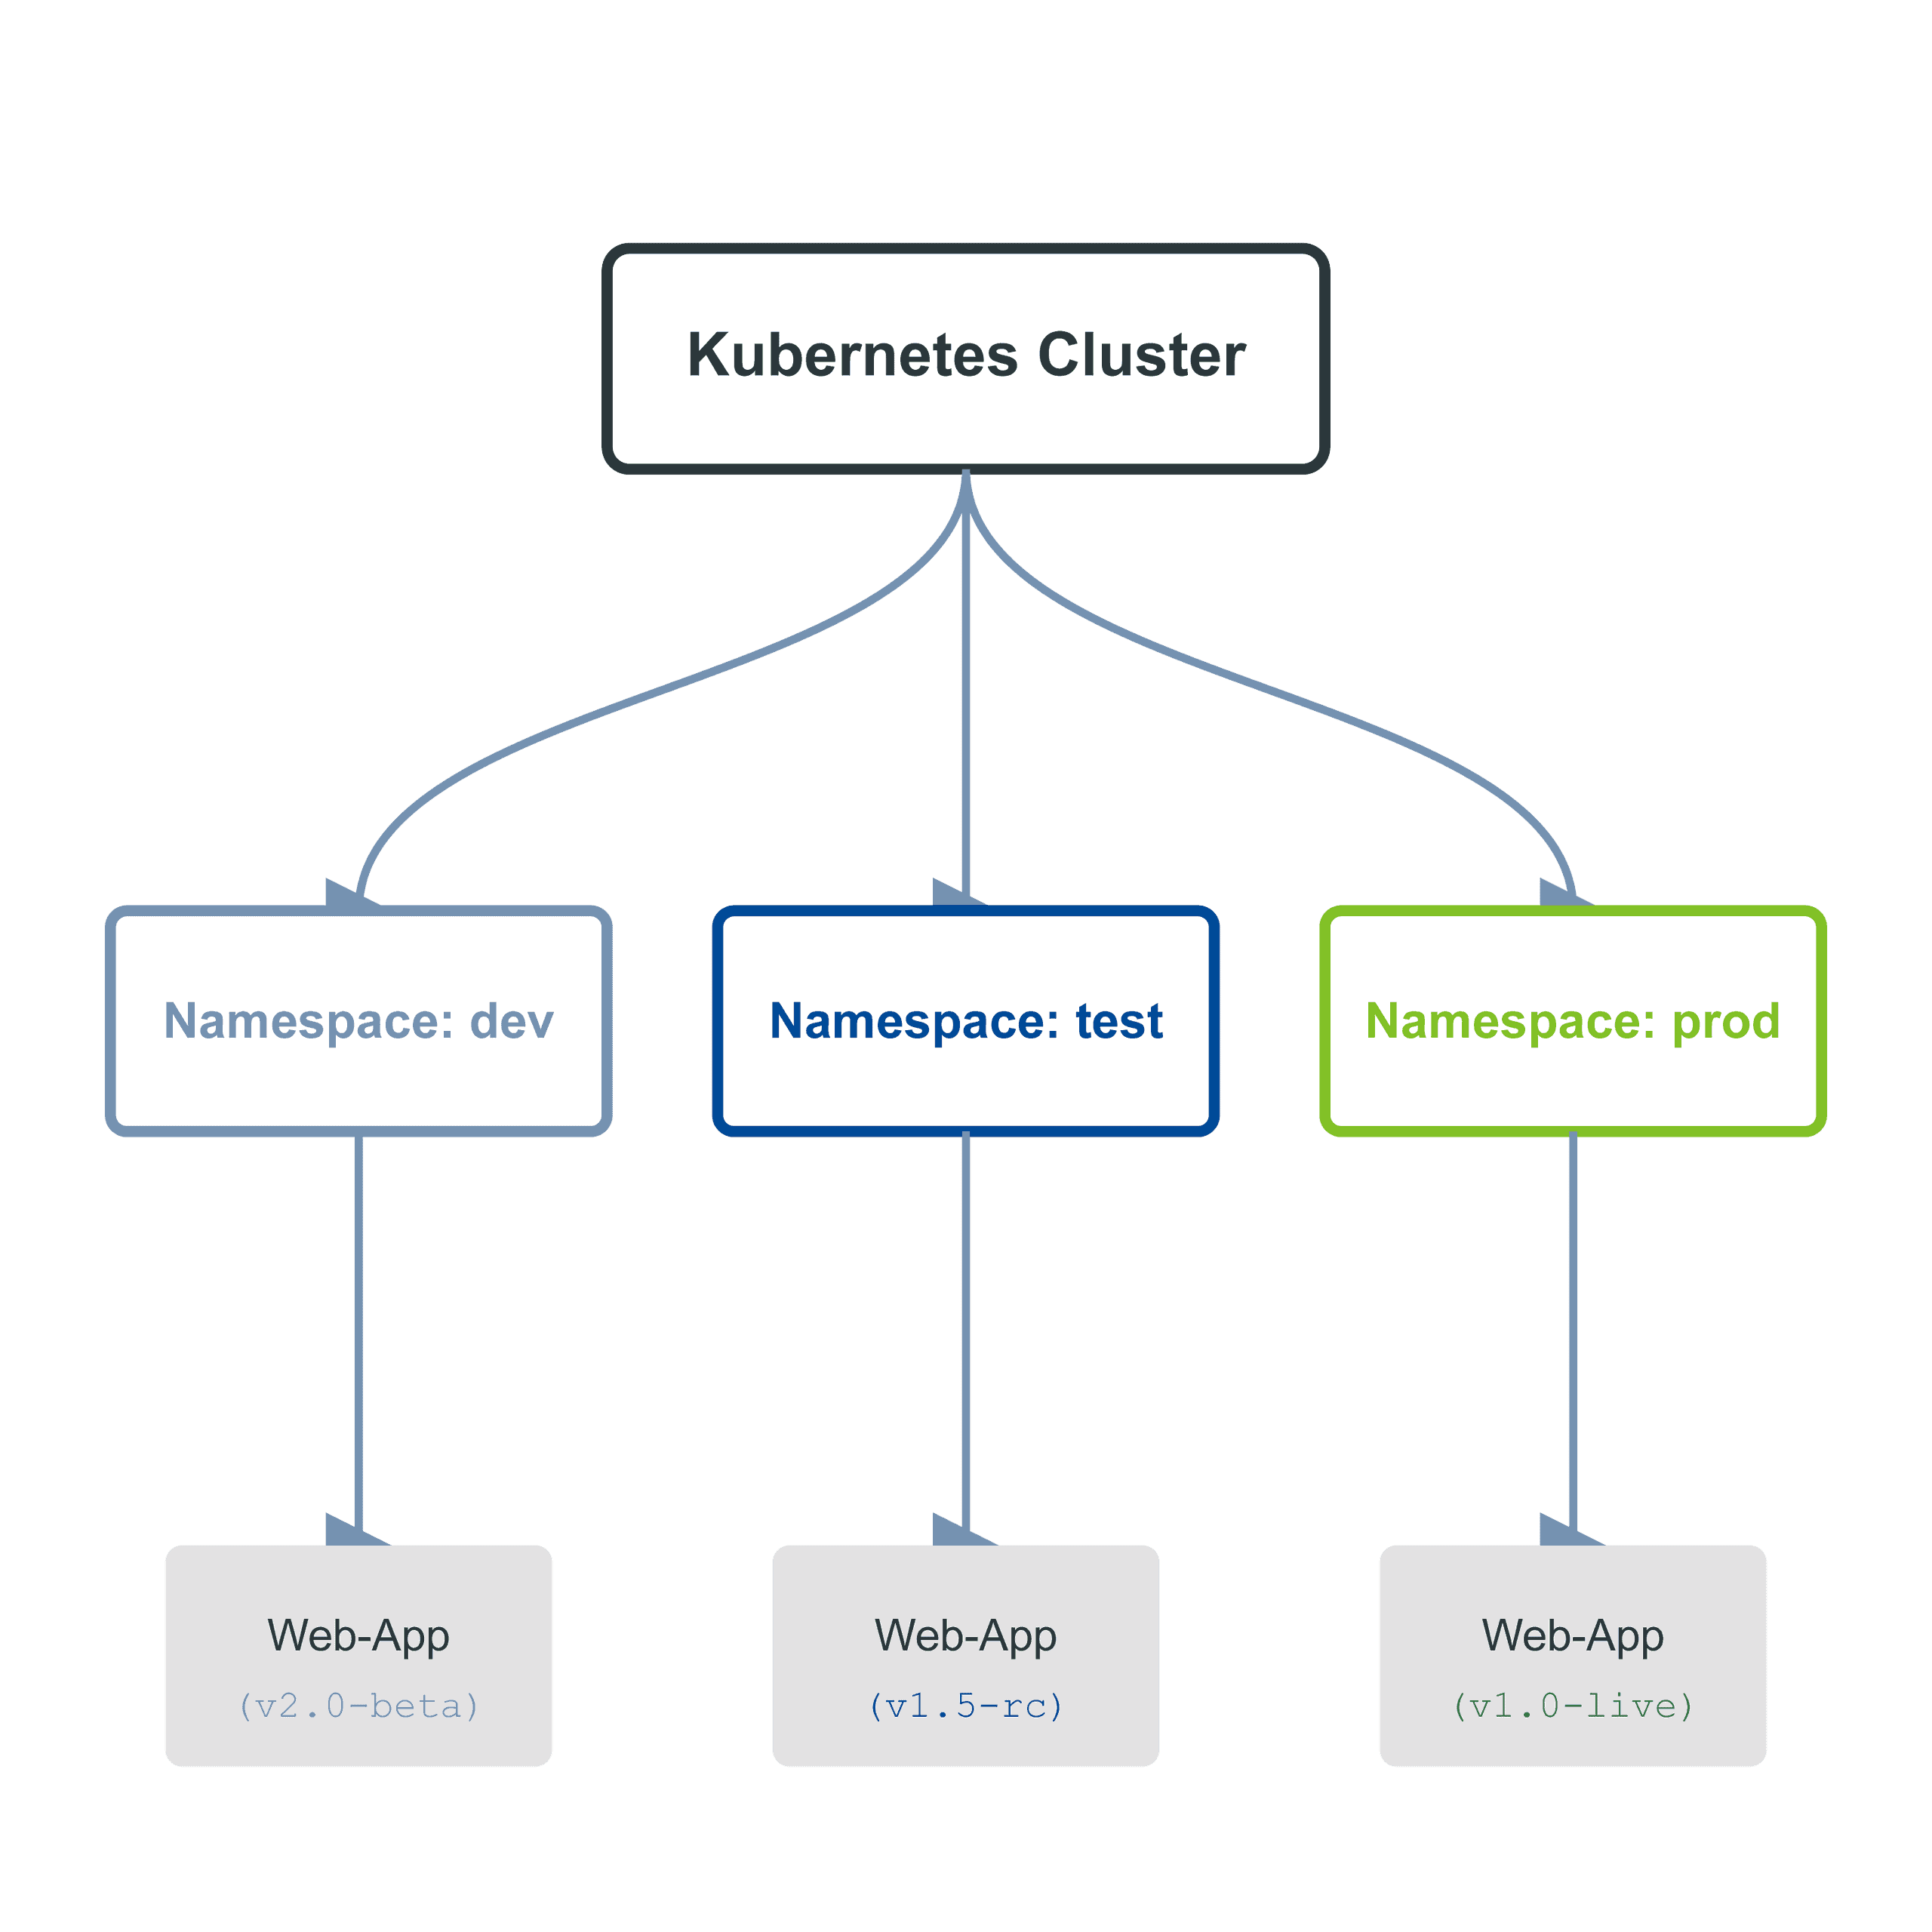
Namespaces teilen ein Cluster in logische Bereiche.
- Trennung nach Team: Team A sieht nicht die Ressourcen von Team B
- Trennung nach Umgebung: Entwicklung, Test, Produktion im selben Cluster
- Zugriffsrechte: Wer darf was, in welchem Namespace?
- Ressourcen-Limits: Pro Namespace ein Budget setzen
Das Kubernetes-Prinzip
Wir haben viel über die Entstehung und die Architektur von Kubernetes erfahren. Eine Frage ist jedoch noch offen: Wie funktioniert das eigentlich genau? Im folgenden Abschnitt erklären wir das Prinzip hinter Kubernetes.
Deklarativ statt Imperativ
Klassische IT-Bereitstellung folgt meist einem imperativen Ansatz. Dabei müssen alle Einzelschritte – vom Einloggen auf Servern über das Stoppen und Neustarten von Anwendungen bis hin zur manuellen Funktionsprüfung – exakt und sequenziell vorgegeben und wiederholt werden. Dieser manuelle Prozess birgt erhebliche Risiken: Tritt bei einem Zwischenschritt ein unvorhergesehenes Problem auf, bricht der gesamte Ablauf ab, was oft inkonsistente und nicht funktionierende Systeme hinterlässt.
Im Gegensatz dazu nutzt Kubernetes ein strikt deklaratives Modell. Hierbei wird nicht der technische Weg diktiert, sondern nur der gewünschte Zustand definiert – beispielsweise drei laufende Pods der Applikation mit spezifischen Ressourcen und Adressen. Die Plattform ermittelt selbstständig die notwendigen Maßnahmen zur Umsetzung, stellt den Zustand her und überwacht das Resultat fortlaufend.
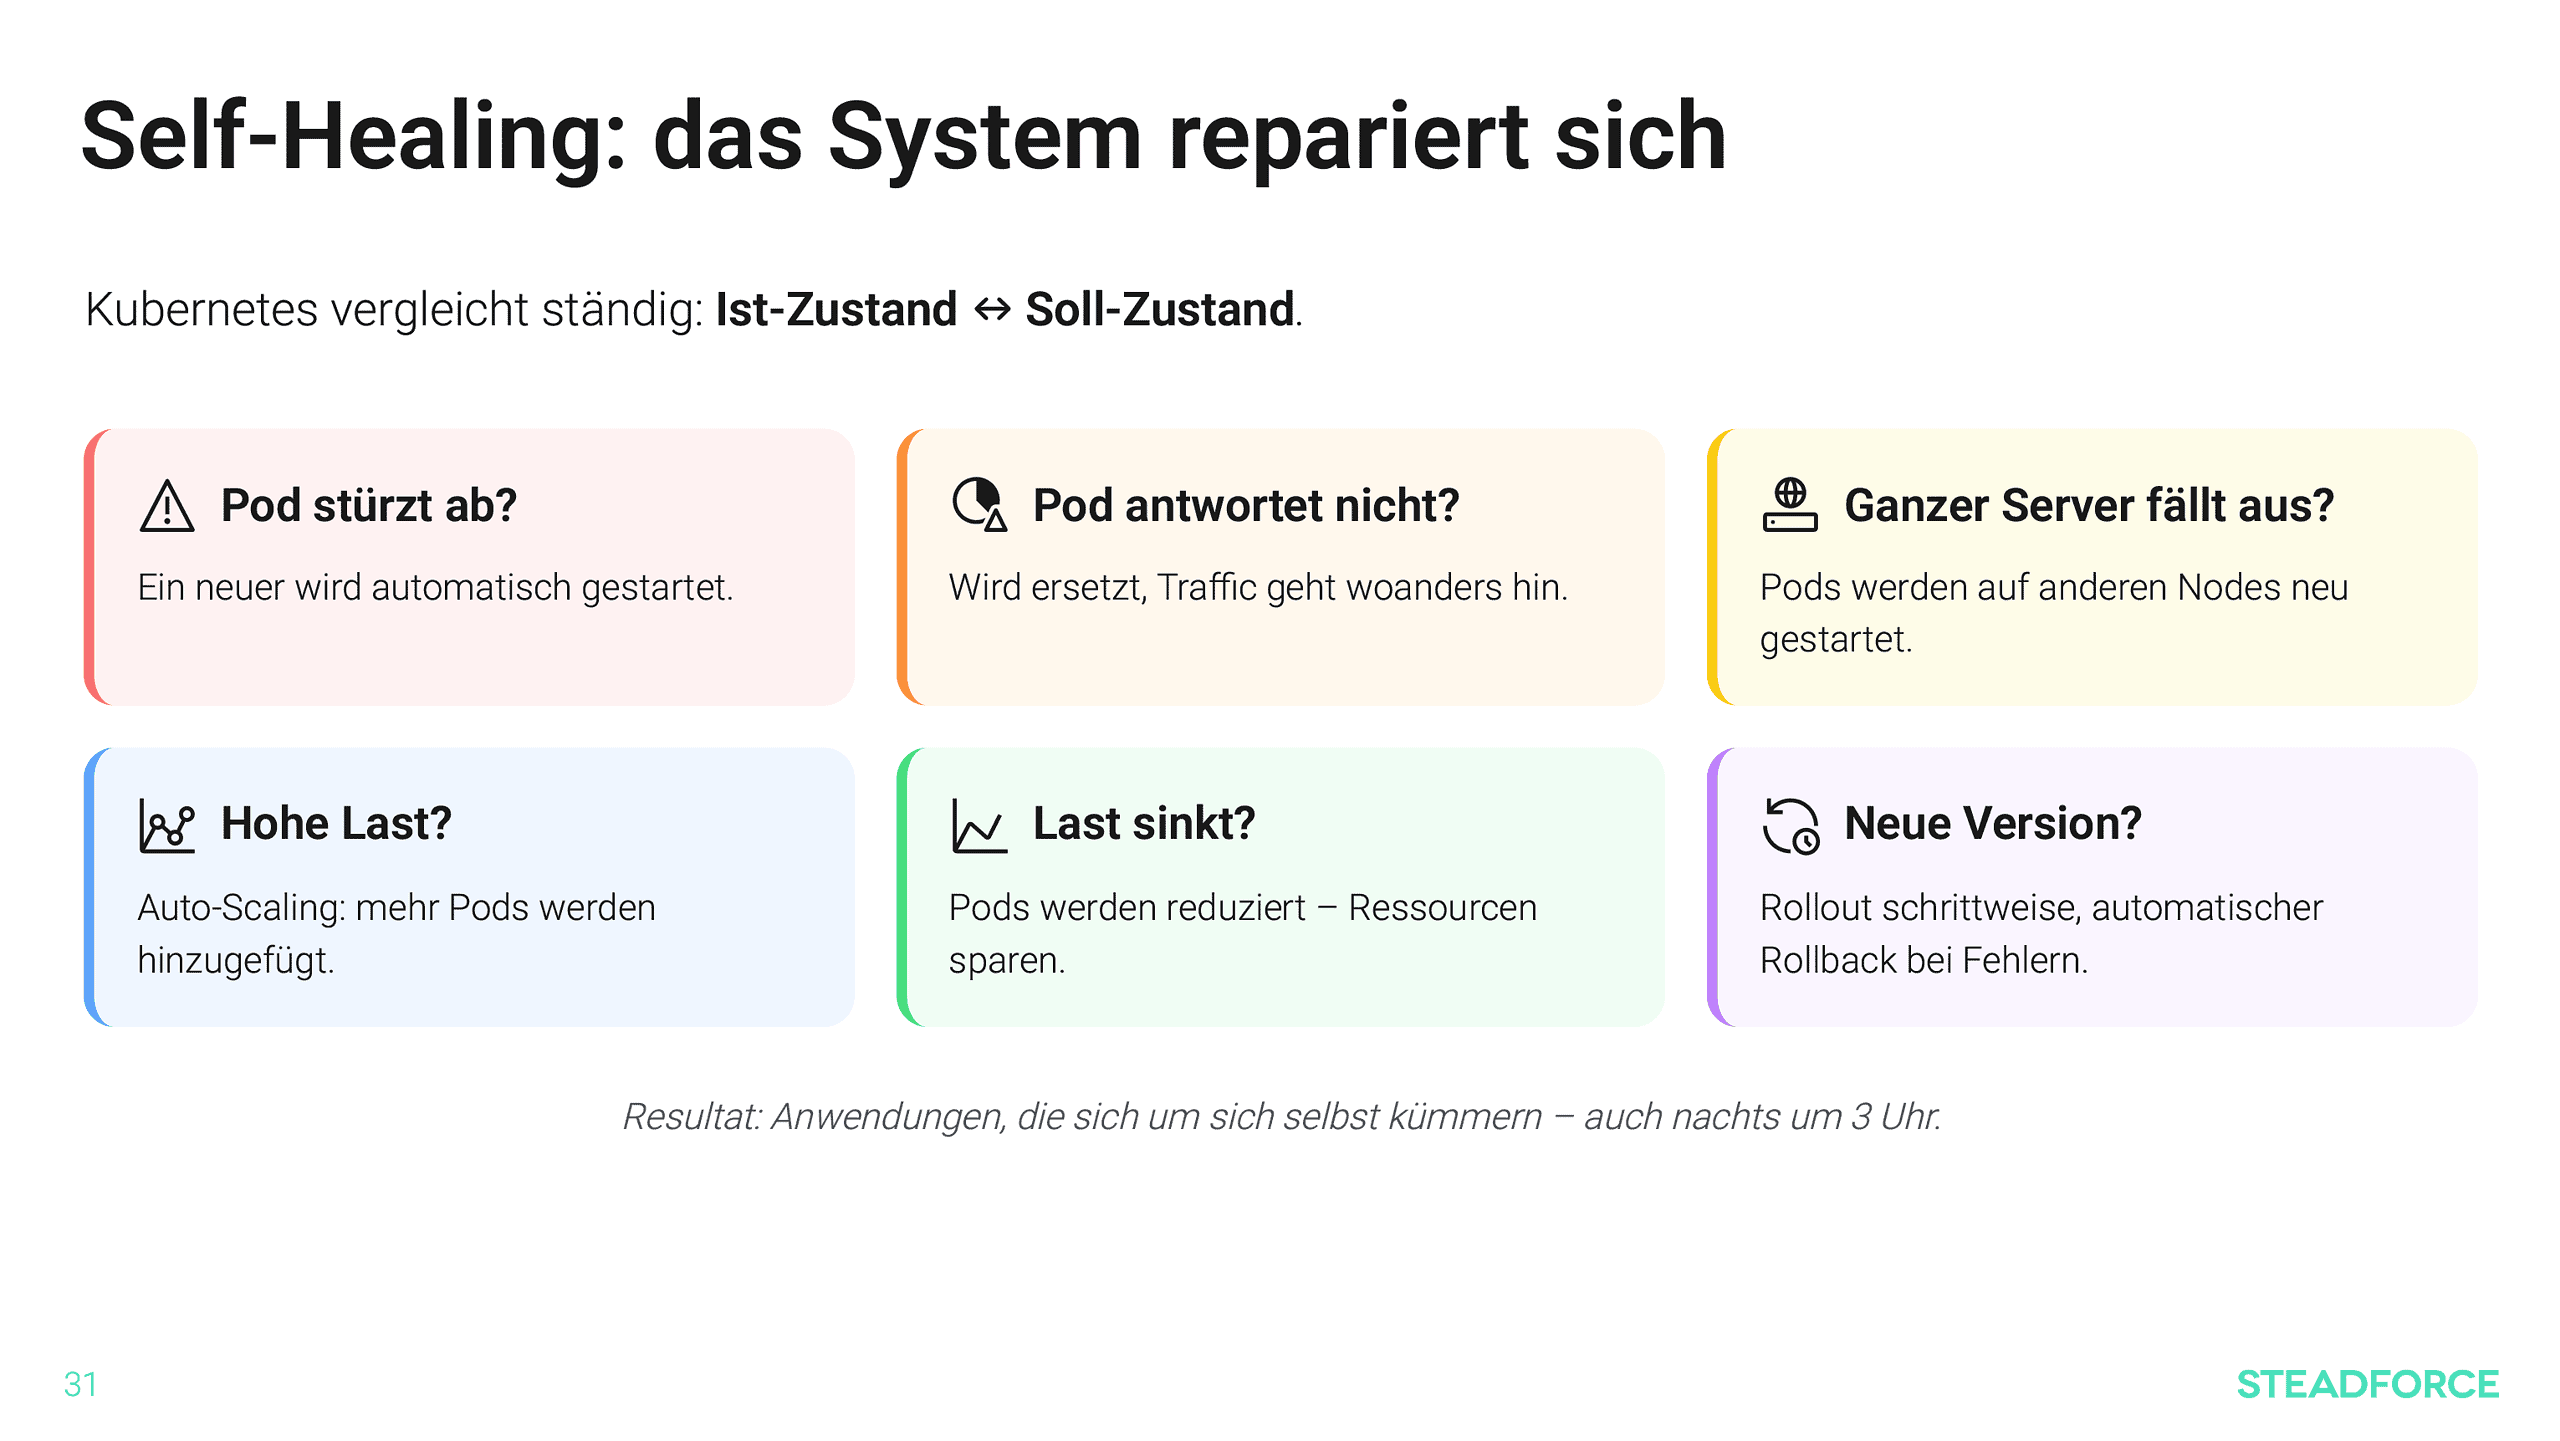
Self-Healing: Das System repariert sich
Kubernetes gleicht kontinuierlich den tatsächlichen Betrieb mit den Vorgaben ab, um Störungen vollautomatisch zu beheben. Stürzt ein Pod ab, antwortet nicht mehr oder fällt gleich ein ganzer Server aus, greift das System sofort ein. Fehlerhafte Instanzen werden beendet, auf intakten Ressourcen neu gestartet und der Datenverkehr nahtlos umgeleitet. Das garantiert höchste Ausfallsicherheit ohne manuelle Notfalleinsätze.
Diese intelligente Automatisierung greift auch bei Updates und schwankender Serverlast. Bei hoher Last skaliert das System selbstständig nach oben; sinkt der Bedarf, werden Ressourcen zur Kostenoptimierung wieder reduziert. Ebenso sicher verlaufen Aktualisierungen auf eine neue Version: Das Rollout erfolgt schrittweise, und bei Fehlern kehrt Kubernetes autonom zum vorherigen, stabilen Zustand zurück.
Das Ökosystem
Kubernetes bildet als reines Orchestrierungs-Fundament lediglich die Basis einer modernen Infrastruktur. Darum herum hat sich auf Open-Source Basis unter dem Dach der Cloud Native Computing Foundation (CNCF) ein Ökosystem aus über 1.000 Projekten entwickelt. Dieser modulare Baukasten erweitert die Plattform passgenau um etablierte Standard-Werkzeuge für den gesamten Betriebsalltag:
- Helm: Agiert als Paket-Manager für die einfache Installation und Verwaltung von Kubernetes-Anwendungen.
- Istio / Linkerd: Bringen als Service Mesh tiefgehende Netzwerk-Intelligenz, Sicherheit und Steuerung in das System.
- Prometheus: Übernimmt das fortlaufende Monitoring und die präzise Erfassung von Systemmetriken.
- Grafana: Visualisiert die gesammelten Systemdaten in übersichtlichen, anpassbaren Dashboards.
- ArgoCD / Flux: Ermöglichen moderne GitOps-Workflows für eine vollständig automatisierte Softwareverteilung.
- Cert-Manager: Kümmert sich im Hintergrund um die automatische Bereitstellung und Erneuerung von TLS-Zertifikaten.
- Loki / ELK: Dienen der zentralen Sammlung und strukturierten Auswertung von Log-Dateien.
- Operators: Bieten spezialisierte Automatisierung für den reibungslosen Betrieb komplexer Anwendungen direkt im Cluster.
Sie haben noch Fragen zu Kubernetes oder möchten sich informieren, wie diese neue Technologie in Ihrem Unternehmen Anwendung finden könnte? Wenden Sie sich gerne an unseren Summit-Referenten Hr. Sammer, contact@steadforce.com
Disclaimer: Alle in diesem Blogbeitrag genannten Marken, Logos und Warenzeichen sind Eigentum der jeweiligen Inhaber und werden hier ausschließlich zu beschreibenden Zwecken verwendet. Teile der Inhalte wurden unter Zuhilfenahme generativer KI-Systeme optimiert.